データの可視化(whis=1.5がデフォルト設定)
データのばらつきや分布構造を一目で可視化できる「箱ひげ図」。マーケティング分析や品質管理、機械学習の前処理といったデータ分析の実務現場で欠かせない基本ツールです。しかし、図の中にぽつんとプロットされる点を見て、「この外れ値はどういう計算式で判定されているのか」「なぜ1.5倍という中途半端な基準を使うのか」と疑問を抱いた経験を持つ方は少なくありません。
集計ツールやBIツールが自動でグラフを描画してくれる現在だからこそ、背後にある統計的ロジックの理解が分析の精度を左右します。本稿では、外れ値判定の根幹である四分位範囲(IQR)の計算手順から、考案者ジョン・テューキーが1.5倍を設定した数学的理由、ExcelやPythonでの表示設定、そして実務現場で最も判断に迷う「外れ値を除外すべきか残すべきか」の基準まで、構造的かつ分かりやすく解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:箱ひげ図の外れ値は、四分位範囲(IQR=Q3−Q1)に「1.5」を掛けた境界線(フェンス)の外側に位置するデータポイントとして定義される。
- 要点2:1.5倍という数値は統計学者ジョン・テューキーが提唱した基準であり、正規分布において約99.3%のデータが収まる確率論的バランスに基づいている。
- 要点3:検出された外れ値を「異常値」と決めつけて即座に除外するのは危険であり、入力ミスと本質的な希少データを峻別した上で分析方針を決定する必要がある。
【仕組みと計算方法】箱ひげ図の外れ値判定と四分位範囲(IQR)の基礎
箱ひげ図における外れ値の検出は、中央値を中心としたデータの散らばり具合を測る四分位範囲(IQR: Interquartile Range)をベースに機械的・客観的に算出されます。平均値や標準偏差を用いた判定とは異なり、極端な値に引きずられにくい(ロバスト性が高い)点が最大の特徴です。
具体的な判定手順は、以下の4ステップで完結します。
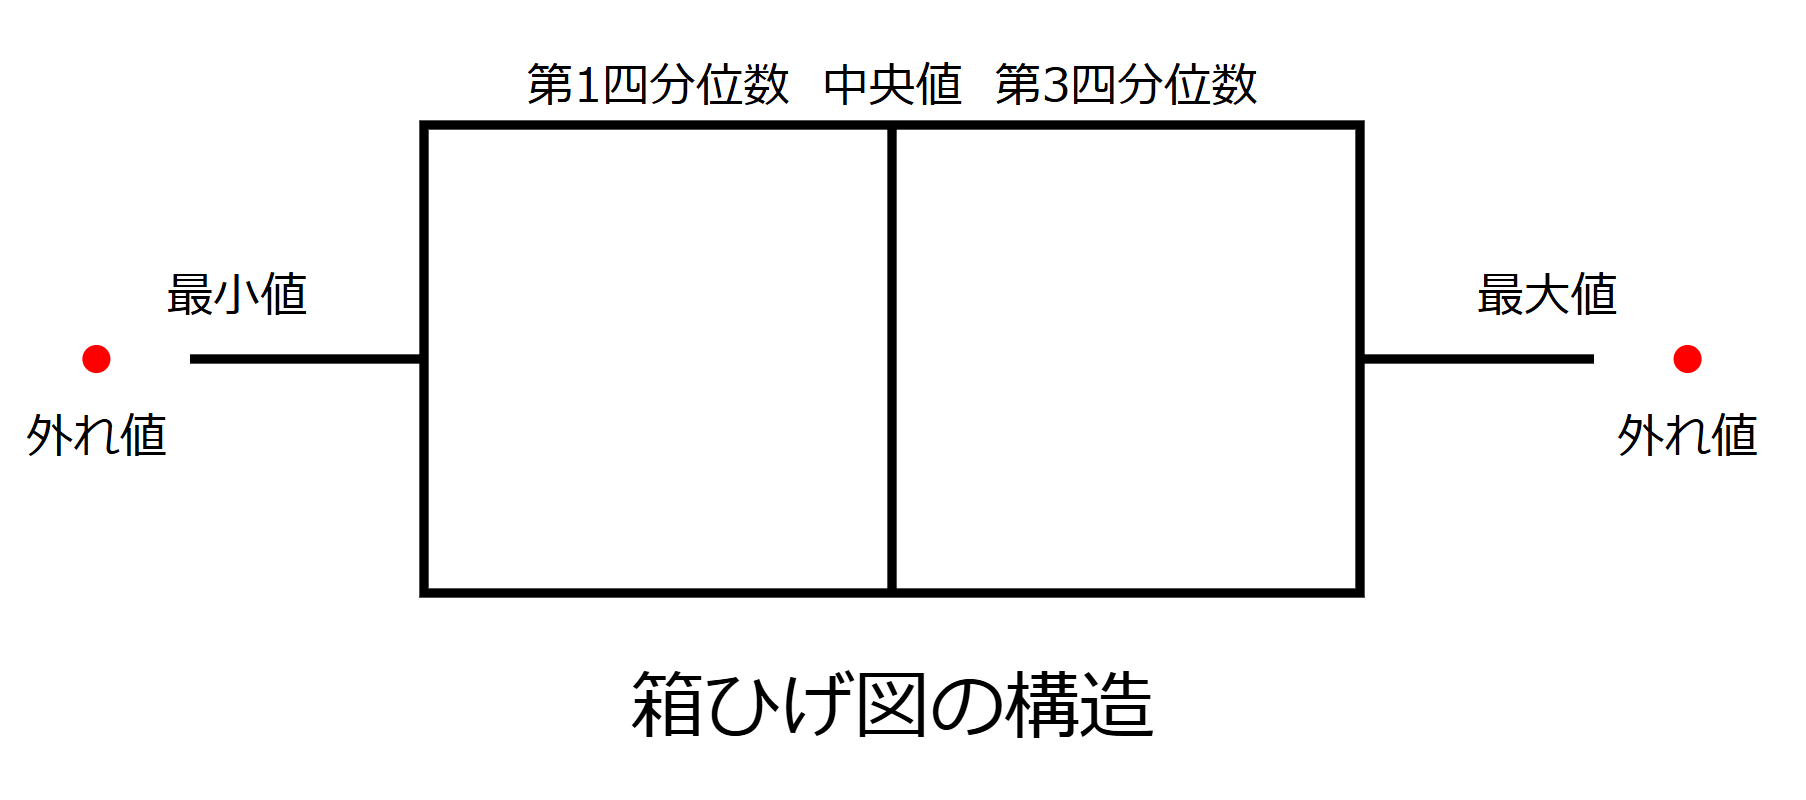
- 四分位数の算出:データを昇順に並べ、下から25%に位置する第一四分位数(Q1)と、下から75%に位置する第三四分位数(Q3)を求めます(50%の位置が中央値Q2です)。
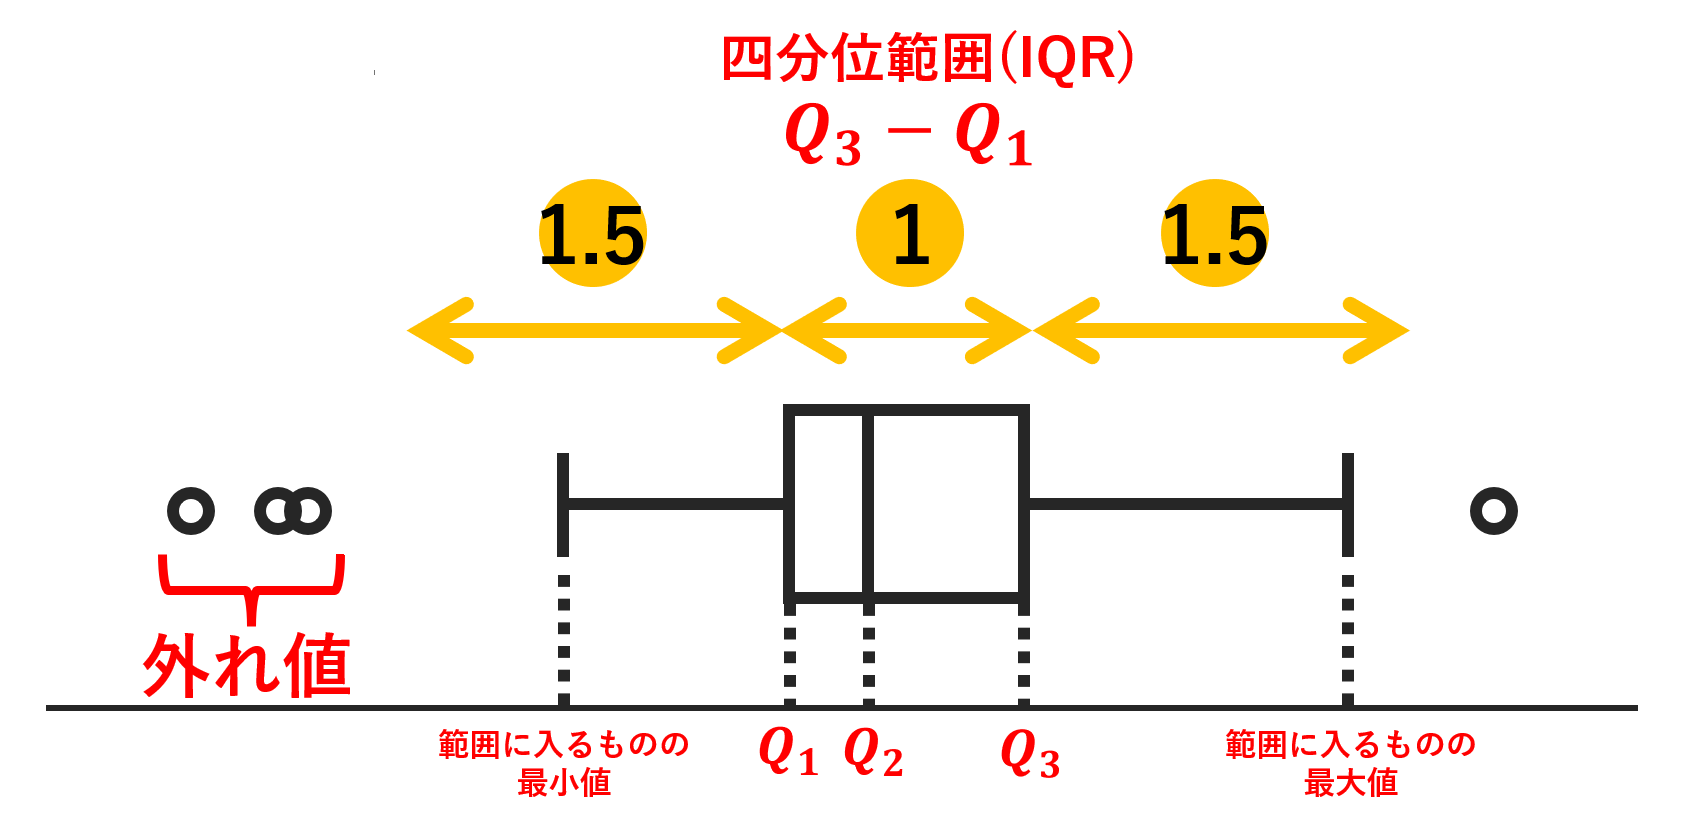
- 四分位範囲(IQR)の計算:箱の長さに相当する「IQR = Q3 - Q1」を計算します。
- 外れ値境界線(フェンス)の設定:
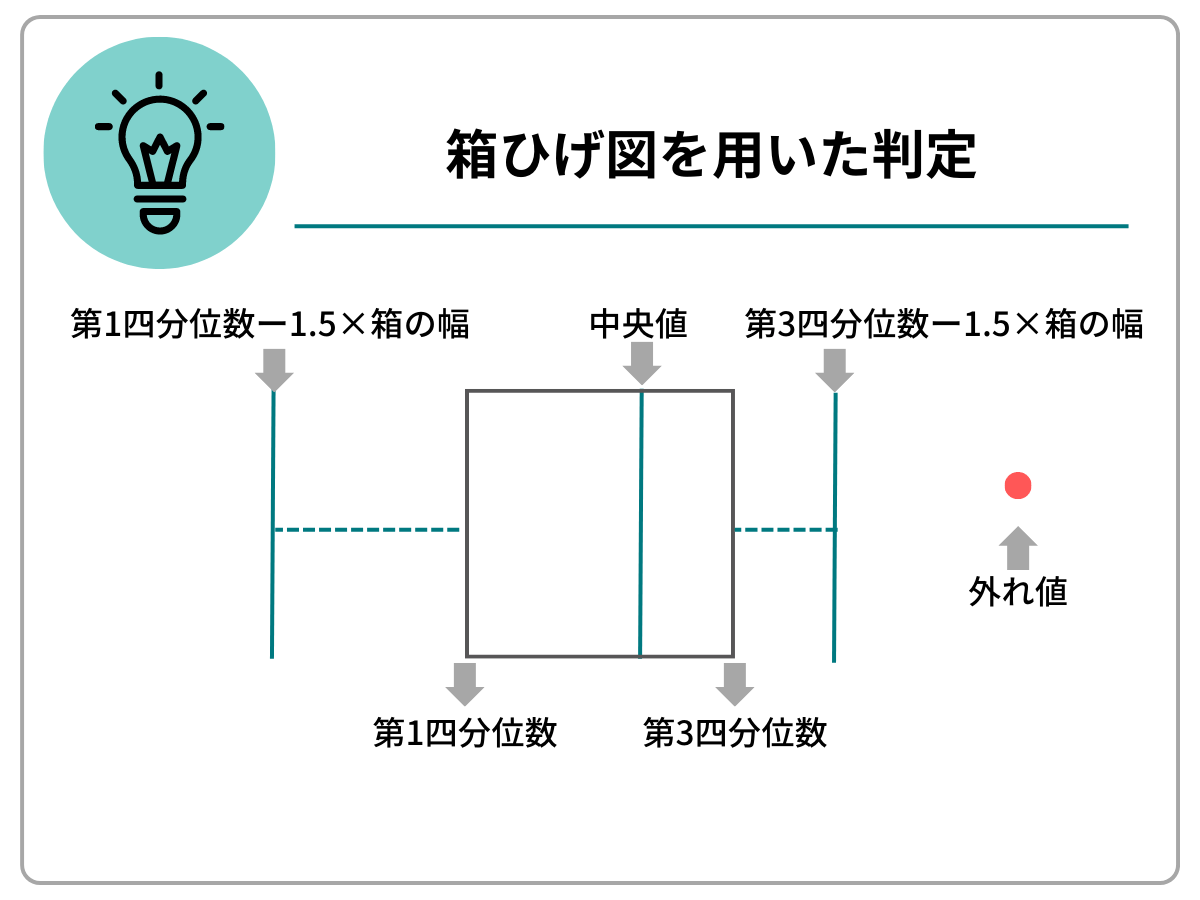
- 下側の基準値(下側フェンス)= Q1 - 1.5 × IQR
- 上側の基準値(上側フェンス)= Q3 + 1.5 × IQR
- 外れ値のプロット:この上下のフェンスを越えた領域にある数値を「外れ値」として判定し、グラフ上には丸印(●や○)やアスタリスク(*)などの独立した記号でプロットします。
ここで重要なのが「ひげの長さ」の決まり方です。外れ値が存在しない場合、ひげはデータの最小値および最大値まで伸びます。しかし、外れ値が存在する場合、ひげの先端は計算上のフェンス(Q1 - 1.5×IQRなど)ではなく、「フェンスの内側に存在する実際のデータの最小値・最大値」で止まります。フェンスそのものの位置までひげが伸びるわけではない点は、初学者が最も誤解しやすいポイントです。
なぜ「1.5倍」なのか?テューキーが導いた統計学的理由と数学的背景
「なぜ2倍や1倍ではなく、1.5倍なのか?」という疑問は、箱ひげ図を扱う誰もが一度は突き当たる疑問です。この1.5倍という基準は、1977年にアメリカの世界的統計学者ジョン・テューキー(John W. Tukey)が著書『Exploratory Data Analysis(探索的データ解析)』の中で提唱したものです。
テューキーが1.5倍を採用した背景には、「正規分布におけるデータの内包率」と「実務上の検知感度」の絶妙なバランスがあります。
データが正規分布(平均 $\mu$、標準偏差 $\sigma$)に従う場合、数学的に四分位範囲は $IQR \approx 1.349\sigma$ となります。これを用いて上下の境界線をシグマ換算すると、以下のようになります。
$$Q3 + 1.5 \times IQR \approx 0.6745\sigma + 1.5 \times 1.349\sigma \approx 2.698\sigma$$
つまり、「Q3 + 1.5×IQR」は約$2.7\sigma$(標準偏差の約2.7倍)に相当します。正規分布において平均から $\pm 2.7\sigma$ の範囲には全体の約99.3%のデータが含まれます。裏を返せば、正常な正規分布データであっても、理論上は約0.7%(片側約0.35%)の確率で外れ値領域に飛び出す計算になります。
テューキーはこの数値を検証した上で、次のように判断しました。
- もし「1.0倍」にした場合:境界線は約 $\pm 2.0\sigma$ となり、正常データの約5%(20個に1個)が外れ値として誤検知されてしまい、ノイズが多すぎる。
- もし「2.0倍」にした場合:境界線は約 $\pm 3.4\sigma$ となり、正規分布から外れるデータはわずか0.07%程度。真に注目すべき異常値やパターンの変化を見逃してしまう。
- 「1.5倍」の設定:正常データを誤って除外しない確実性を保ちつつ(99%以上をカバー)、異常な傾向を持つデータを適度に浮かび上がらせる「探索的スクリーニングに最適な閾値」である。
なお、テューキーの手法では、1.5×IQRを超えるものを「外れ値(Outlier / 内側フェンス外)」、さらに3.0×IQRを超える極端な値を「極度の外れ値(Far Outlier / 外側フェンス外)」として区別して扱う体系が整備されています。
【比較表】代表的な外れ値検出手法と箱ひげ図(IQR法)の評価
データ分析で利用される外れ値検出手法は、箱ひげ図(IQR法)だけではありません。データの性質や分布の前提条件に応じて最適な手法を選択する必要があります。
| 手法名 | 検出ロジック・計算アプローチ | 適用前提・一般的な基準 | メリット・現場での評価 |
|---|---|---|---|
| IQR法(箱ひげ図) | 中央値・四分位範囲に基づく幾何学的判定(Q1/Q3 ± 1.5×IQR) | 特定の分布を前提としない(ノンパラメトリック) | ◎ 最適:外れ値自身の影響を受けず、直感的に把握可能。初期分析の第一選択。 |
| 3シグマ法(Zスコア) | 平均値からの標準偏差の乖離($|Z| > 3$ を外れ値とする) | データが「正規分布」に近似していることが必須 | △ 注意:極端な外れ値があると平均値や標準偏差自体が歪むため、単一の異常値に弱い。 |
| マハラノビス距離 | 複数変数の相関関係(共分散)を考慮した多次元距離の測定 | 多変量正規分布、変数間の線形関係 | ◯ 高度:多次元データ同士の相関を崩す「組み合わせの異常」を検知できる。 |
| アイソレーションフォレスト | 決定木を用いて孤立しやすいデータポイントを機械学習で分割・スコアリング | 高次元データ、非線形・複雑な分布 | ◯ 自動化:機械学習パイプラインでの自動異常検知に向くが、解釈性は箱ひげ図に劣る。 |
実務の現場において箱ひげ図(IQR法)が最も重宝される理由は、「どのようなデータに対しても破綻しにくい頑健性(ロバスト性)」にあります。平均値はたった1つの極端な値で大きく変動してしまいますが、四分位数に基づく箱ひげ図は分布の骨格を保ったまま異常値を浮き彫りにしてくれます。
【実践手順】ExcelとPythonによる外れ値表示・可視化の設定
概念を理解したところで、実務で頻繁に使われるExcel(エクセル)とPythonでの具体的な操作・描画手順を確認します。
1. Excelで箱ひげ図の外れ値を表示・非表示にする方法
Excel 2016以降、箱ひげ図は標準グラフとして簡単に作成できるようになりました。
- 対象のデータ範囲を選択し、上部メニューの「挿入」→「統計グラフの挿入」→「箱ひげ図」を選択します。
- 描画されたグラフのデータ系列(箱の部分)を右クリックし、「データ系列の書式設定」を開きます。
- 系列のオプション内にある「外れ値のポイントを表示する」のチェックボックスを確認します。
- チェックON:1.5×IQRを超えるデータが個別の点(マーカー)としてプロットされ、ひげはフェンス内の最大・最小値までとなります。
- チェックOFF:外れ値の個別プロットが消え、ひげがデータ全体の絶対的な最大値・最小値まで強制的に延長されます。
※注意点として、Excelの四分位数計算(QUARTILE.INC / QUARTILE.EXC)の仕様により、後述のPythonやRと微妙に境界値が異なるケースがあります。公式報告資料ではどちらの計算方式を採用しているか把握しておくことが推奨されます。
2. Python(Seaborn / Matplotlib)での実装
Pythonを用いたデータ分析環境では、seabornライブラリを使用するのが最も標準的です。
import seaborn as sns import matplotlib.pyplot as plt sns.boxplot(data=df, y='target_column', whis=1.5) plt.title("Boxplot with 1.5x IQR Outliers") plt.show() パラメータ whis=1.5 を whis=3.0 に変更すればテューキーの極度外れ値基準に切り替えることができ、whis=[0, 100] と指定すれば外れ値をプロットせず最小値から最大値までひげを伸ばす描画が可能です。
一般に知られていない盲点とネットの誤解
現場の分析業務において、箱ひげ図の外れ値にはいくつかの危険な「思い込み」が存在します。統計的な誤謬を避けるために知っておくべき3大盲点を整理します。
誤解1:「外れ値=不正なデータなので即座に削除すべき」
現場で最も頻発するミスが、外れ値が出た瞬間に機械的に除外(行削除)してしまう処理です。箱ひげ図の外れ値は「統計的な境界の外にある」ことを示しているに過ぎず、それが「測定エラー」なのか「正当な特異データ」なのかは文脈を見なければわかりません。
例えば、ECサイトの購買データ分析において、1回で100万円を購入した超優良顧客は統計上「外れ値」になります。これをシステムエラーとして除外してしまえば、売上の大部分を占めるロイヤルカスタマーの購買行動を見落とすことになります。
誤解2:「ひげの先端=データの最大値・最小値である」
外れ値がプロットされているグラフにおいて、ひげの先端はデータの絶対的な最大値ではありません。ひげの先端はあくまで「境界線(Q3 + 1.5×IQR)の内側にある最も大きな値」です。全体の最大値は、外側にプロットされた一番上の点であることを正しく読み取る必要があります。
誤解3:「左右非対称に歪んだ分布でも1.5倍が無条件に通用する」
年収データ、Webサイトのアクセス数、アプリの課金額などは、左側にデータが密集し右側に極端に長い裾野を持つ「歪んだ分布(対数正規分布やべき乗分布)」をとります。このようなデータに標準の1.5×IQRを適用すると、右側の正常な上位データが大量に外れ値として検出されてしまう現象が起きます。歪みが激しいデータでは、対数変換(Log Transform)を行ってから箱ひげ図を作成するか、メディアン・絶対偏差(MAD)を用いた別アプローチを検討するのが鉄則です。
【実態検証】利用者の生の声と現場目線で見えたリアル
データ分析を推進する企業や教育現場、実務アナリストのコミュニティでは、箱ひげ図の運用をめぐって様々な摩擦や試行錯誤が報告されています。
【現場の声:事業会社マーケティング担当(30代)】
「上長への月次レポートで箱ひげ図を提出したところ、『この上の点々(外れ値)は異常値なんだから、除外してグラフを作り直せ』と指示されました。しかし実際にはキャンペーン初日のバズによる正当な流入でした。数式上の外れ値と、ビジネス上の異常値の違いを非エンジニア層に説明する難しさを痛感しています。」
【現場の声:データサイエンス専攻大学院生】
「Excelで出力した箱ひげ図と、PythonのSeabornで出力した箱ひげ図で、同じデータなのに外れ値の数が1個ズレて悩んだ経験があります。調べてみると四分位数のパーセンタイル計算式(排他と包含の違い)が原因でした。ツール間のアルゴリズムの差異は侮れません。」
このように、ツール側の計算定義の違いや、ビジネスサイドとの「外れ値に対する認識のギャップ」が、現場における大きな摩擦要因となっています。
【プロの判断基準】外れ値を除外すべきケース・残すべきケース
外れ値に直面した際、データ分析者が取るべき具体的な意思決定フローを以下に提示します。
外れ値を除外(クリーニング)すべきケース
- 明らかな入力ミス・システムエラー:年齢欄に「999」、アンケート回答に「-1」、センサーの一時的な通信断によるゼロ値など、論理的にあり得ない数値。
- 調査対象外(異質な母集団)の混入:BtoCサービスの利用ログに、社内テスターやスクレイピングBOTのアクセスが紛れ込んでいる場合。
- 正規分布を仮定するアルゴリズムの学習前処理:線形回帰分析など、外れ値によってモデル全体の傾きが著しく歪んでしまう機械学習モデルを組む場合。
外れ値を残す(あるいは独立して分析する)ケース
- 異常検知・不正検出そのものが目的の場合:クレジットカードの不正利用検知や工場の設備故障検知では、外れ値こそが発見すべき「真のターゲット」です。
- 裾野の広いビジネス指標:売上高、富裕層の資産規模、SNSの拡散数など、べき乗則に従う事象。
- 判断がつかないグレーゾーン:外れ値を除外したデータセットと、残したデータセットの両方で分析を実施(感度分析)し、結論が大きく変わらないか検証するのが最も誠実なアプローチです。
【プロの結論】箱ひげ図分析が適しているデータ・見送るべきデータ
- 適している:複数グループ間のばらつき比較(例:支社別の営業成績、製造ラインごとの寸法誤差比較、テストのクラス別成績分布)。
- 見送るべき(他の可視化を推奨):山が2つ以上ある「多峰性データ」(バイオリンプロットやヒストグラムを推奨)、サンプルサイズが極端に小さいデータ(ストリッププロットや散布図を推奨)。
【箱ひげ図の外れ値】に関するよくある質問(FAQ)
Q1:エクセルの箱ひげ図で外れ値の点が表示されません。何が原因ですか?
A1:データ系列の書式設定で「外れ値のポイントを表示する」のチェックが外れているか、すべてのデータが1.5×IQRのフェンス内に収まっており統計的な外れ値が存在しないことが考えられます。系列オプションの設定画面を確認してください。
Q2:外れ値の境界を1.5倍から変更することは統計的に認められていますか?
A2:はい、目的が明確であれば問題ありません。特に極端な異常値のみをスクリーニングしたい場合は「3.0倍(極度外れ値)」が学術的にも広く使われます。ただし、基準を変更した場合は分析レポート内に「本分析では3.0×IQRを外れ値基準として定義した」旨を明記する必要があります。
Q3:外れ値が多すぎて箱がつぶれて見えなくなってしまいます。どうすればいいですか?
A3:データが対数正規分布など右に大きく歪んでいる可能性が高いです。縦軸を「対数スケール(Log軸)」に変更するか、元の数値を対数変換($\log(x+1)$)してから箱ひげ図を描画すると、箱の形状と外れ値の分布が綺麗に確認できるようになります。
まとめ:外れ値を正しく読み解きデータ分析の精度を高めるために
箱ひげ図の外れ値判定に用いられる「1.5倍」という数値は、単なる慣習ではなく、正規分布の統計的性質と実務的な扱いやすさを両立させるためにジョン・テューキーが綿密に導き出した合理的な閾値です。
データ分析において、外れ値は「邪魔なノイズ」であると同時に、「新たなビジネスチャンスや潜在的リスクを知らせるシグナル」でもあります。計算ロジック(IQRの1.5倍)を正しく理解し、安易な削除を避け、データの文脈に合わせた柔軟な判断を下すことこそが、信頼性の高いデータ活用を実現するための第一歩となります。 (出典: 箱 ひげ 図 外れ 値(Yahoo!ニュース))
最新のトレンドや話題のニュースをわかりやすく解説するWebライターです。読者の皆様に役立つ情報を日々お届けしています。